2 окт 2026
 7 мин.
LLM для разработки: сравниваем восемь моделей на задачах RuStore
Содержание
Выбрать LLM для разработки по публичным бенчмаркам не так просто. Они показывают возможности модели на стандартизированных задачах, но не отвечают на вопрос, как она поведёт себя в конкретном проекте.
Мы в RuStore решили протестировать их самостоятельно. Рассказываем как проводили эксперимент, что получилось и насколько результаты совпали с тем, что можно было ожидать от моделей.
Что мы хотели проверить
Конечно, публичные тесты помогают сравнивать модели, но для выбора рабочего инструмента нам хотелось проверить их на своём коде: с нашими модулями, архитектурой, конвенциями и Gradle-сборкой.
Нас интересовали три момента: насколько полно модель решает задачу, сколько времени на это тратит и во сколько обходится запуск через API.
Для этого мы взяли девять задач из истории разработки RuStore и прогнали на них восемь моделей: GPT-6 Sol, Luna и Astra; Claude Opus 5.5, Fable 5.1 и Sonnet 5; DeepSeek Flash и Grok 4.7.
Как мы тестировали модели
Мы выбрали разные типы задач: пользовательские сценарии, работу с данными и системными ресурсами в мобильном приложении и Android TV. Для каждой задачи мы подготовили состояние репозитория до внесения решения.
Условия для всех моделей были одинаковыми: одна и та же версия задачи, одно сообщение с инструкциями и один запуск на пару «задача × модель». По ходу работы мы не давали дополнительных подсказок и не выбирали лучшую из нескольких попыток. Для всех моделей мы использовали настройку effort high. GPT запускали через Codex, остальные модели — через Claude Code.
Как оценивали результаты
Оценивать решения одной моделью — плохая идея, поэтому мы использовали перекрёстную оценку GPT-6 Astra и Claude Fable 5.1. Каждый судья оценил все 72 решения, включая решения своей модели. Решения были анонимизированы: названия моделей и таблица соответствий судьям не передавались.
Оценка проходила в два этапа:
- Сначала каждый судья отдельно изучал решение, результаты проверок и эталонную реализацию из истории проекта;
- Затем сравнивал свои заключения по всем решениям одной задачи и при необходимости уточнял оценки.
На втором этапе судья видел только свои заключения — без доступа к репозиториям. Поведение и качество кода оценивались отдельно.
Итог по каждому критерию считали как среднее оценок двух судей с весами 50/50. Время и число обращений к инструментам фиксировал runner. Расхождения между оценками сохраняли в отчёте вместе с пояснениями.
Во время работы модели не видели скрытые тесты и эталонную реализацию. После завершения запуска мы выполняли проверки на полученном решении и на эталоне. При этом прошедшие тесты не гарантировали максимальный балл: судьи также проверяли код на нарушения требований и пограничные случаи.
Подход перекрёстной оценки уменьшил зависимость результата от одного судьи, хотя полностью субъективность оценки не устранил.
Что получилось
Для практического выбора мы задали веса: 50% результативность, 35% скорость, 15% стоимость. Результативность объединила выполнение требований и качество кода с весами 75/25. Время и стоимость мы нормализовали логарифмически внутри этой группы моделей.
Вот что получилось с учётом этих весов. Баллы даны по шкале 0–100 и не означают процент решённых задач. Время и расчётная стоимость указаны суммарно за девять запусков каждой модели.
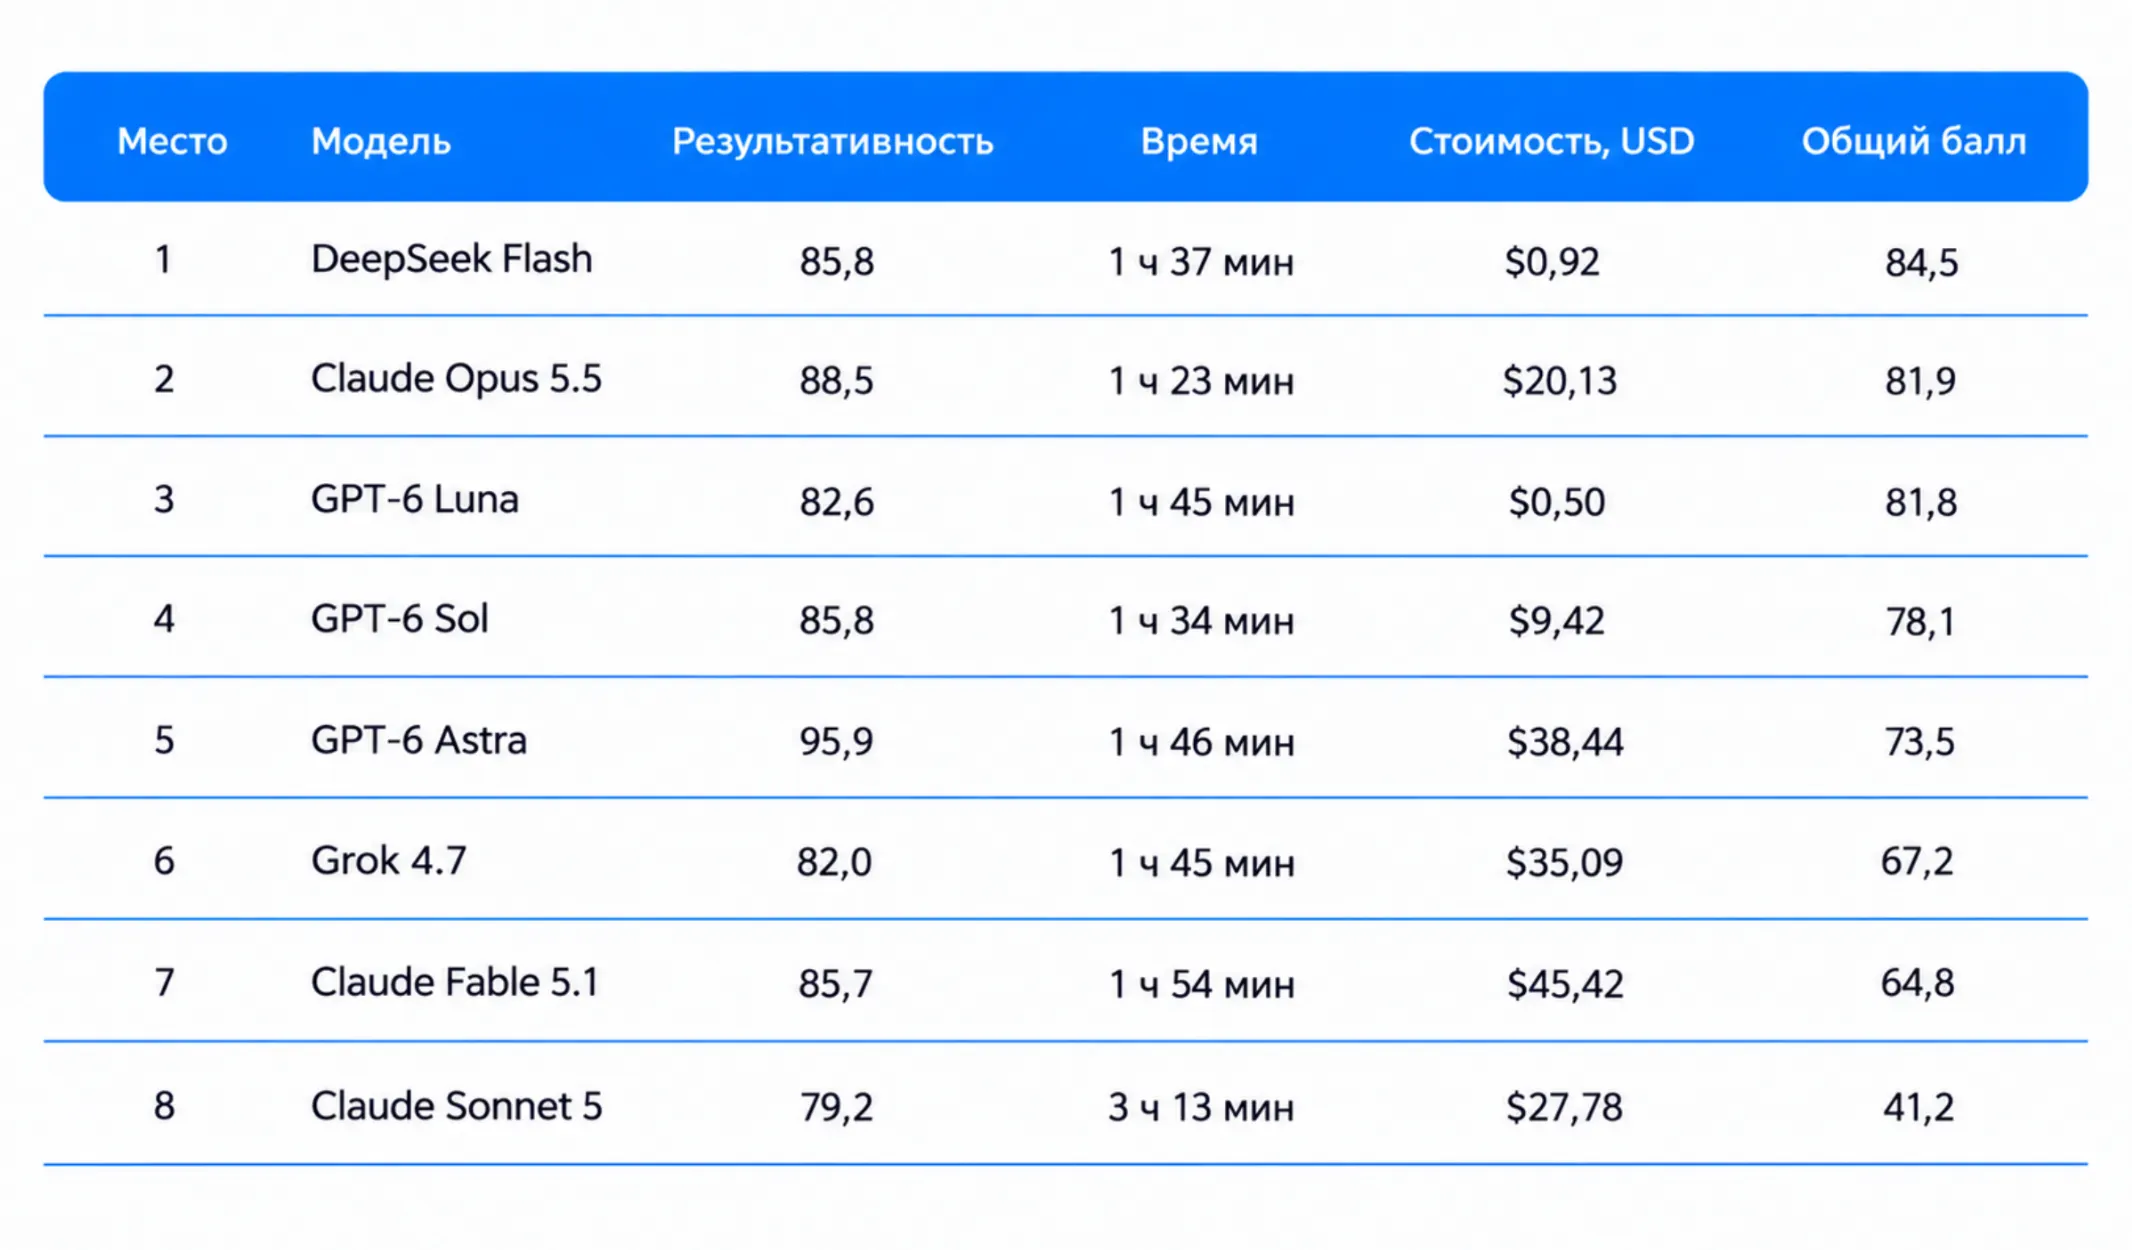
Стоит заметить, что цена заметно влияет на итоговый результат при оценке моделей. Если её исключить и сохранить соотношение весов результативности и скорости, первые позиции занимают Opus 5.5, Astra и Sol.
Поэтому при выборе модели полезно смотреть не только на общий балл, но и на отдельные показатели.
Какую модель выбрать
Если смотреть в первую очередь на стоимость, выделяются Luna и DeepSeek Flash:
- Luna оказалась самой дешёвой моделью в тесте и вошла в тройку по общему баллу;
- Flash получил самый высокий общий балл с учётом цены, а по результативности практически сравнялся с Sol.
Внутри линейки GPT Sol оказался быстрее и результативнее Luna, но заметно дороже.
Opus 5.5 показал лучшее сочетание результативности и скорости без учёта цены, а Astra получил максимальную результативность.
При этом результаты линейки Anthropic в целом заметно разошлись: Opus оказался самым быстрым, а Sonnet получил самый низкий общий балл как с учётом цены, так и без неё.
Как анализировать эти результаты
Важно учитывать ограничения эксперимента. Мы проверили модели на девяти задачах одного Android-проекта и сделали по одному запуску на каждую пару «задача × модель». Поэтому результаты относятся не только к самим моделям, но и к агентским инструментам и среде, в которой они работали.
Проверки с устройством или эмулятором в этом тесте не выполнялись. Фактический backend за gateway независимо не подтверждён.
Стоимость рассчитана по счётчикам токенов и зафиксированным для бенчмарка ставкам на 25 сентября. Это оценка, а не оплаченный счёт. Для DeepSeek использован сценарий 40% потребления по пиковым ставкам и 60% по внепиковым. Работа судей в стоимость девяти model runs не включена.
Вместо вывода
Наш эксперимент не выявил одну модель, которая была бы лучшей по всем критериям. Результат заметно менялся в зависимости от того, какой вес мы давали стоимости, скорости или результативности.
При наших весах максимальный общий балл получил DeepSeek Flash. При этом, без учёта стоимости, как мы отметили выше, первые позиции займут уже другие модели, а максимальную результативность покажет Astra.
В завершении хочется отметить, что результаты относятся к конкретному набору Android-задач, инструментов и настроек. На другом проекте или при других приоритетах результат может измениться, поэтому такой тест мы рекомендуем рассматривать не как универсальный рейтинг LLM, а как способ понять, какая модель лучше подходит под конкретный сценарий разработки в ваших проектах.
💙 Мы в MAX